Modelos open-weights para agentes: quando vale a pena rodar
Saiba o que são modelos open-weights, como o motor de inferência serve agentes com continuous batching e cache de prefixo, e quando rodar local compensa.
TL;DR: Modelos open-weights são pesos que você pode baixar e rodar na sua própria infraestrutura — GLM-5.2, DeepSeek V4, Qwen3-Coder e Kimi K2.6 estão entre os melhores de 2026. Servir um modelo para agentes tem mecânicas próprias — prefill e decode, continuous batching, cache de prefixo — e a conta de qual caminho compensa depende de volume, privacidade e hardware, não de uma regra única.
Em harness e loop, o modelo era o motor e o harness era o chassi. E a disputa de 2026, escrevi lá, tinha migrado para o chassi.
Vale a pena abrir o capô de novo. Porque agora existe uma pergunta prática circulando entre quem paga cada token em dólar: se os modelos abertos evoluíram tanto, faz sentido baixar um e rodar você mesmo?
A resposta curta é sim — com ressalvas que dependem do seu caso. A resposta útil exige entender três coisas: o que são esses modelos, como um motor de inferência serve um agente e quanto custa cada caminho. É o que vamos abrir agora.
O que são modelos open-weights?
Modelos open-weights são modelos cujos pesos treinados são públicos: qualquer pessoa pode baixar, rodar e fazer fine-tune na própria infraestrutura. O que não vem junto é o dataset e o código de treinamento.
Por isso “open-weights” não é sinônimo de “open-source”. A distinção importa:
- Open-source: pesos, arquitetura e código de treino abertos — auditável de ponta a ponta.
- Open-weights: só os pesos finais. É o caso da maioria dos modelos abertos de 2026, incluindo todos os citados aqui.
- Fechado: nada é público; acesso só via API. Claude, GPT e Gemini funcionam assim.
Na prática, open-weights dá a você três superpoderes: rodar sem mandar seus dados para fora, congelar uma versão que não muda debaixo dos seus pés e especializar o modelo com fine-tune. Em troca, você assume GPU, energia e operação.
Segundo o levantamento da Faros AI de julho de 2026, os principais modelos abertos para programação são:
| Modelo | Destaque | Arquitetura | Contexto | Licença |
|---|---|---|---|---|
| GLM-5.2 | Agentes de engenharia de longa duração | 753B / 40B ativos (MoE) | 1M | MIT |
| DeepSeek-V4-Pro | Raciocínio de fronteira com custo baixo | 1,6T / 49B ativos (MoE) | 1M | MIT |
| Kimi K2.6 | Multimodal e orquestração multi-agente | 1,04T / 32B ativos (MoE) | 262K | MIT modificada |
| MiniMax M3 | Vazão alta com custo baixo | 428B / 23B ativos (MoE) | 1M | Custom |
| Qwen3-Coder | Uso local e self-hosted | 80B / 3B ativos (MoE) | 262K | Apache 2.0 |
| Llama 4 | Multimodal nativo | 400B / 17B ativos (MoE) | 1M | Llama Community |
Repare no tamanho da primeira linha: 753 bilhões, 1,6 trilhão de parâmetros. E todos aí são MoE (mixture of experts): o modelo guarda muitos parâmetros, mas ativa só uma fração deles por token — é isso que “40B ativos” quer dizer. Open-weights não significa “roda no seu PC” — os modelos que disputam o topo dos benchmarks pedem clusters de GPU.
E tem um segundo detalhe: os fechados ainda não foram ultrapassados no topo absoluto. No mesmo levantamento, o Claude Opus 4.8 marca 69,2% no SWE-bench Pro contra 62,1% do GLM-5.2 — e a Faros é explícita: para o trabalho agêntico mais complexo, os modelos de fronteira fechados ainda lideram.
O recorte honesto do “rodar local” não é o topo dos benchmarks. É a faixa de 30 a 80 bilhões de parâmetros — que cabe numa GPU de consumidor e foi exatamente onde os laboratórios concentraram esforço. Chegamos lá já já.
Como funciona servir um modelo para agentes?
Serving é o trabalho que acontece entre o seu pedido e a resposta: o motor que transforma prompt em tokens. Rodar local é operar esse motor; usar API é terceirizá-lo.
Entender o motor explica a maior parte do que você sente na prática — latência, custo por execução e até por que agentes ficam mais caros a cada turno.
O que são prefill e decode?
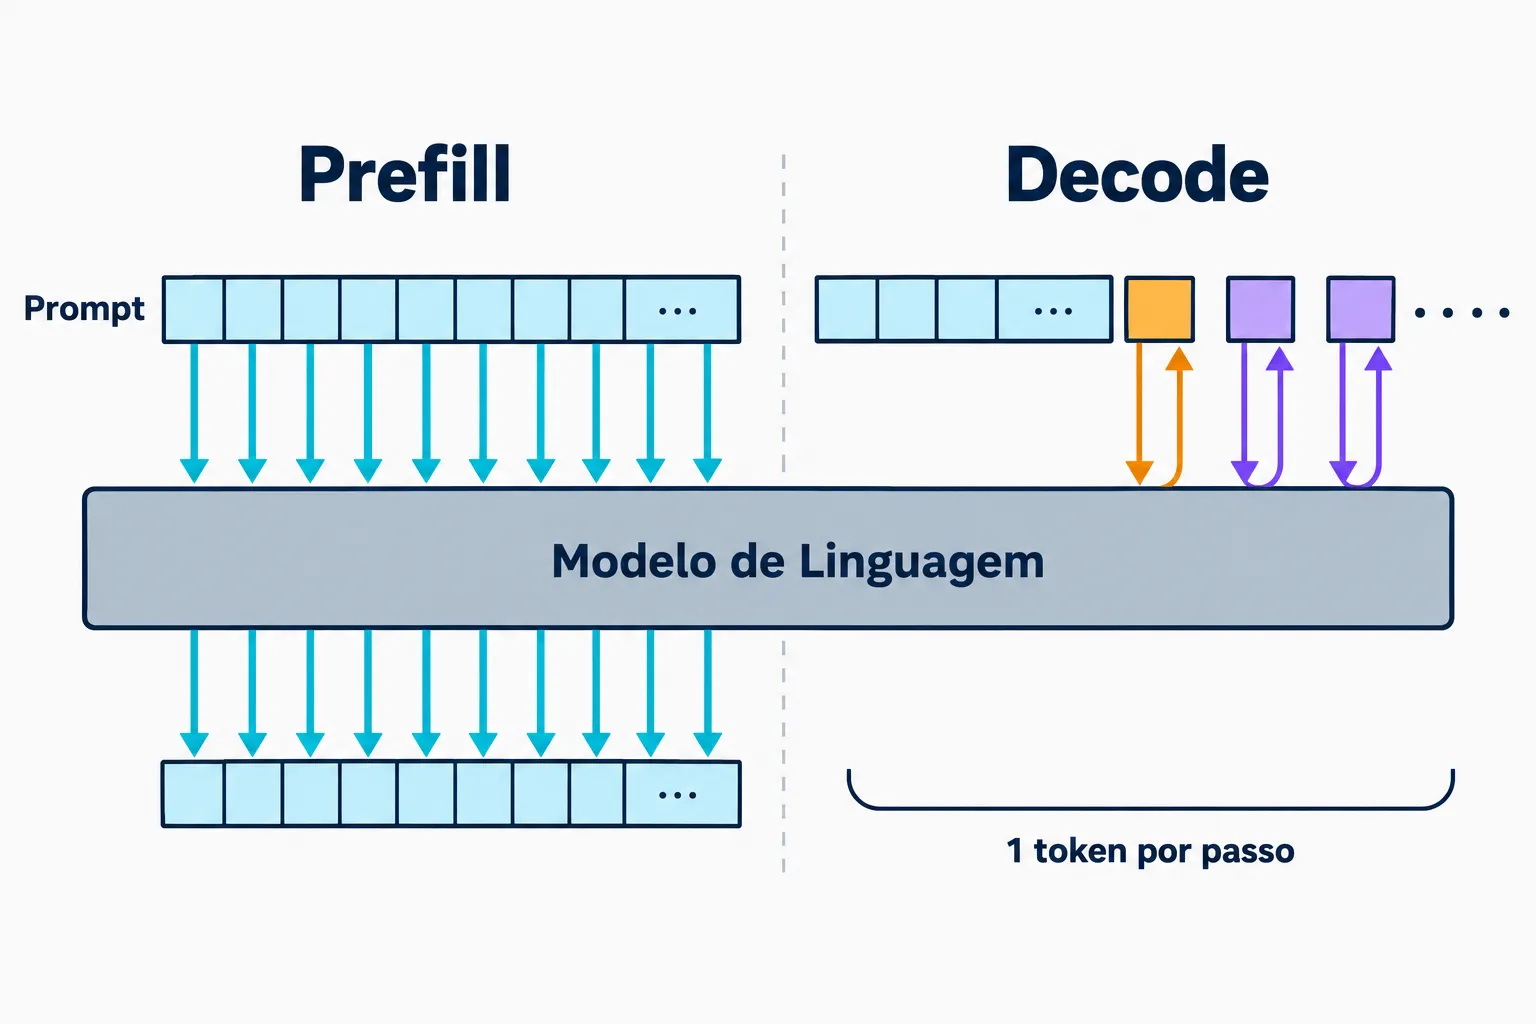
Toda chamada ao modelo acontece em duas fases. No prefill, o modelo processa o prompt inteiro de uma vez — todos os tokens em paralelo — e monta o KV cache, as representações de atenção que ele vai reutilizar. No decode, a resposta sai token por token: cada token novo exige uma passada completa pela rede.
Aí mora a assimetria: o prompt do agente cresce sem parar (system prompt, definições de tools, histórico, arquivos), mas ninguém sabe quantos tokens a resposta terá até ela terminar.
No serving tradicional de machine learning, batch é uma matriz de linhas fixas — todas terminam juntas. Requisições de LLM não se comportam assim: cada uma ocupa a GPU por um tempo imprevisível. Empacotadas no formato antigo (batch estático), as requisições curtas ficam esperando as longas, e a GPU passa a maior parte do tempo ociosa.
O que é continuous batching?
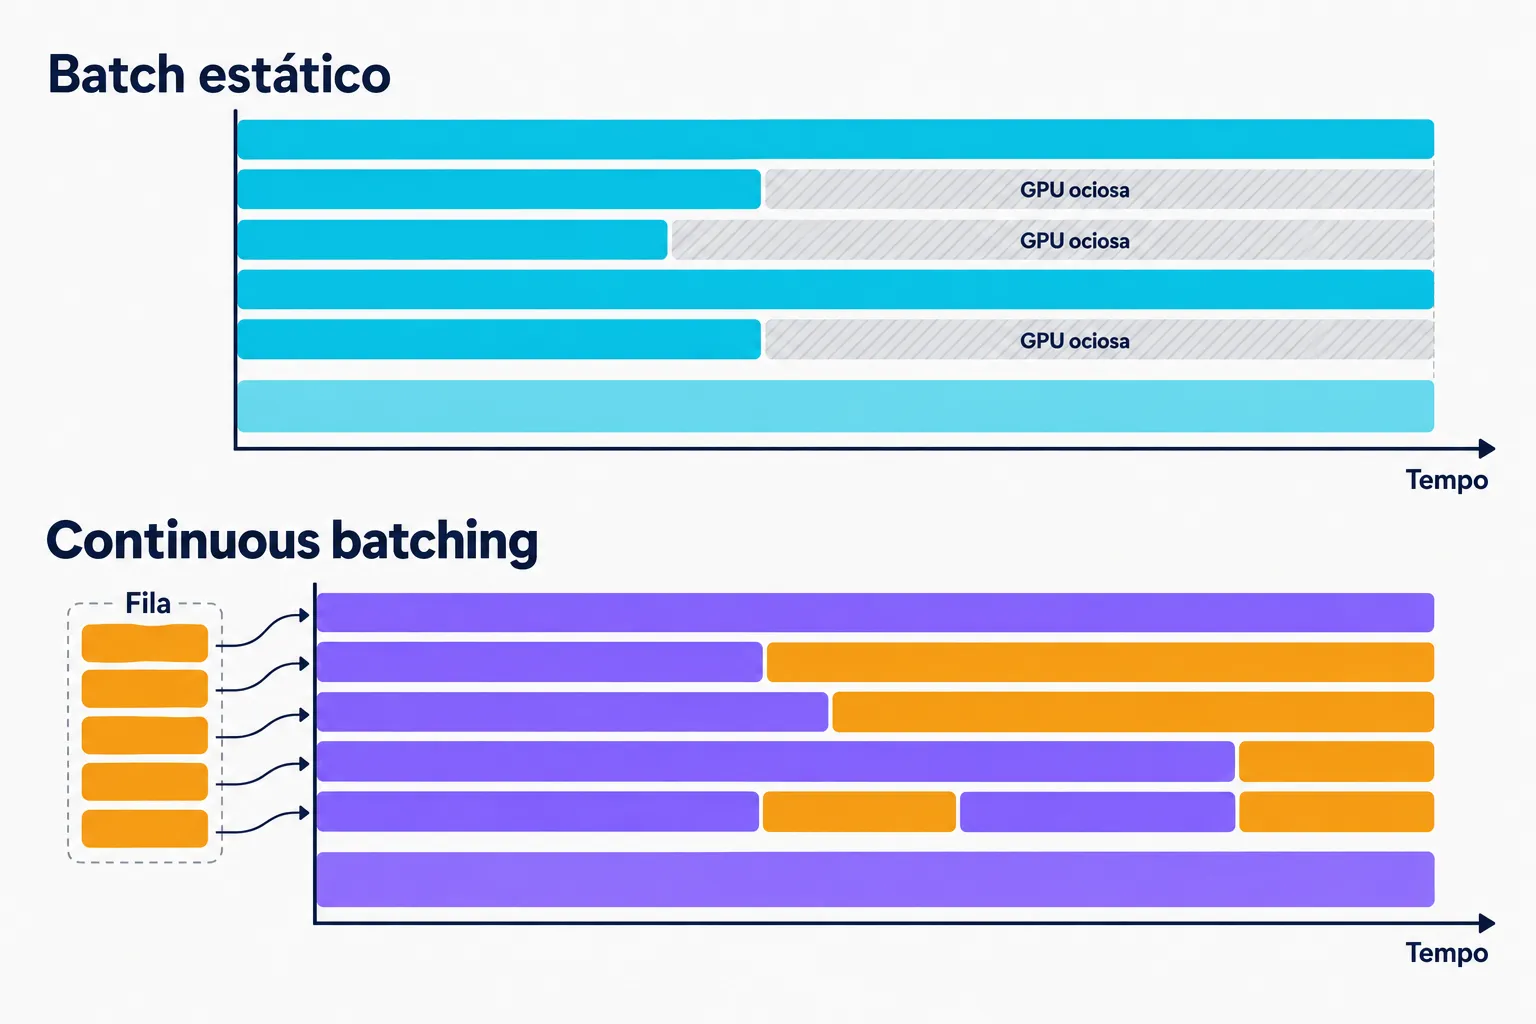
Continuous batching é o scheduling em nível de iteração: a cada passo, o motor decide quais requisições avançam — sem deixar a GPU esperar a linha mais lenta. Foi a técnica que deu ao vLLM o ganho de cerca de 23× de throughput (a vazão total do motor: tokens por segundo somando todas as requisições) sobre o serving ingênuo do Hugging Face nos benchmarks da Anyscale (OPT-13B em uma A100, 2023) — e virou padrão em todo engine sério.
O jeito mais claro de entender o scheduler do vLLM V1 é compará-lo a um maestro que se pergunta, a cada compasso: quantos tokens cada requisição precisa agora?
- Ele define o orçamento do passo — quantos tokens cabem nesta rodada (
max_num_batched_tokens). Esse é o dial entre latência e throughput. - Para cada requisição em andamento, entrega os tokens que faltam para o próximo objetivo: um prompt recém-chegado de 4.096 tokens pede 4.096; uma resposta no meio do caminho pede 1. É a mesma linha de código para os dois casos.
- Reserva os blocos de KV cache correspondentes — a memória entra na conta na hora da decisão, não depois. Se não houver espaço, o motor preempta: tira a requisição mais nova da execução e, quando ela voltar, refaz o prefill (recompute).
- O que sobra do orçamento vai para a fila de espera.
Três elegâncias de brinde: prompts gigantes são fatiados em partes (chunked prefill), tokens já em cache não são recalculados, e prefill e decode compartilham o mesmo caminho — o motor só faz uma pergunta: “quantos tokens faltam para essa requisição?”.
Para um agente, o efeito é direto: sessões longas, com dezenas de turnos e tool calls, mantêm a GPU ocupada de ponta a ponta em vez de enchê-la com uma requisição de cada vez.
O que é cache de prefixo?
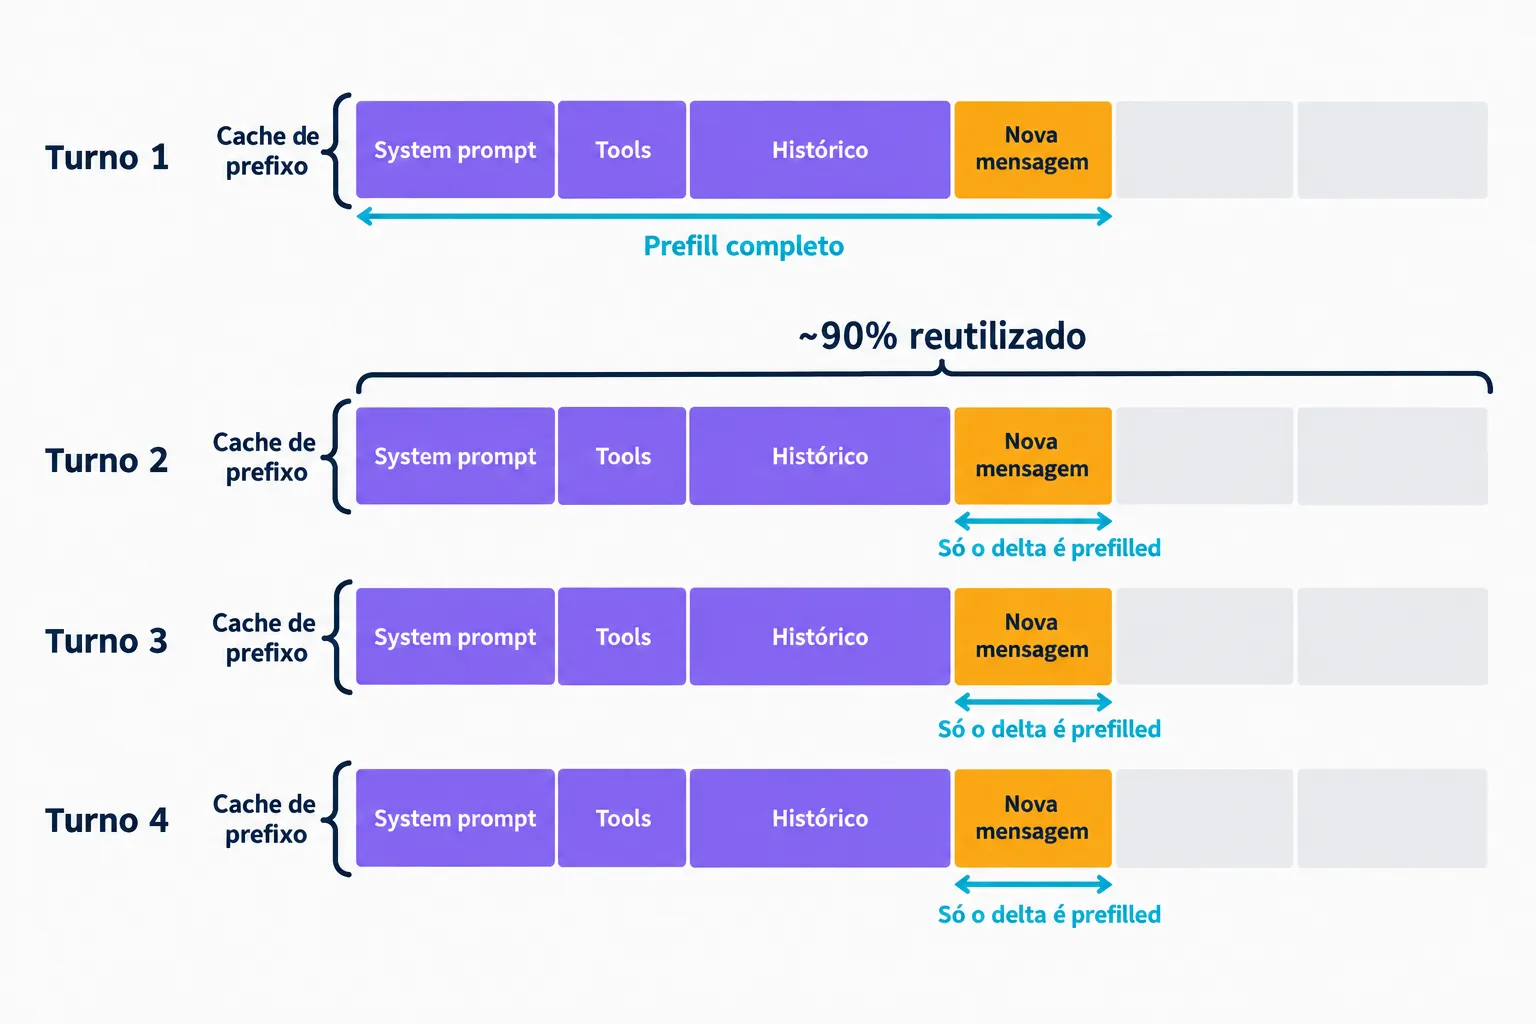
Cache de prefixo é a reutilização dos blocos de KV cache de um prefixo idêntico entre chamadas. E nenhum workload aproveita isso melhor que um agente: segundo uma RFC aberta no repositório do vLLM, mais de 90% dos tokens de um turno típico de agente são prefixos repetidos — o mesmo system prompt, as mesmas tools, o mesmo histórico.
O vLLM faz isso automaticamente (automatic prefix caching) e o SGLang com o RadixAttention. Só o delta da conversa precisa de prefill; o resto é lido do cache.
Esse é o lado de sistemas do context engineering — e explica um desconto que muita gente não conhece nas APIs comerciais. Na Anthropic, um cache hit custa 10% do preço de input. Na DeepSeek, o cache hit do V4-Flash sai a US$ 0,0028 por milhão de tokens: cinquenta vezes mais barato que o input normal, que já é US$ 0,14.
A consequência prática cabe num aviso: mudanças que parecem inofensivas — reordenar o system prompt, regerar as definições de tools a cada turno, editar o começo do histórico — invalidam o cache e você paga o prefill inteiro de novo. Em agentes com muitos turnos, é a diferença entre uma conta saudável e uma conta que assusta.
Quanto custa rodar um modelo local?
Existem três caminhos, com estruturas de custo diferentes: API (paga por token), GPU alugada (paga por hora) e GPU própria (paga uma vez — mais energia, depreciação e o seu tempo de operação).
A conta: API, GPU alugada ou GPU própria?
A fórmula é direta: custo por milhão de tokens = (preço da GPU por hora) ÷ (tokens por segundo × 3.600 ÷ 1.000.000). A parte difícil é que tokens/s varia com modelo, quantização e tamanho do contexto — por isso a recomendação é medir, não estimar.
E aqui vem o número contraintuitivo. Segundo a análise de custos da Spheron (outubro de 2026), contra APIs baratas o self-hosting quase nunca ganha:
- Para superar o Claude Opus, o ponto de virada fica entre 31 e 36 milhões de tokens por dia num cluster econômico (pesos comprimidos a 4 bits, INT4, em instâncias spot — capacidade ociosa mais barata, mas interrompível) — ou 105 milhões por dia num cluster de produção (FP8, on-demand).
- Para bater a própria API da DeepSeek (V4-Flash), seriam cerca de 831 milhões de tokens por dia.
O motivo é simples: cluster de GPU não é grátis, e API barata é muito barata. O DeepSeek V4-Flash cobra US$ 0,14 por milhão de input e US$ 0,28 por milhão de output — abaixo do que a maioria das GPUs alugadas consegue entregar por token. Para referência, os preços de outubro de 2026:
| API | Modelo | Input (US$/M) | Output (US$/M) |
|---|---|---|---|
| DeepSeek | V4-Flash | 0,14 | 0,28 |
| Gemini 3.5 Flash-Lite | 0,30 | 2,50 | |
| Anthropic | Claude Sonnet 5.5 | 2,00 | 10,00 |
| Anthropic | Claude Opus 5.5 | 4,00 | 20,00 |
| OpenAI | GPT-5.6 Sol | 5,00 | 30,00 |
Do outro lado, alugar uma GPU avulsa: RTX 4090 na faixa de US$ 0,13 a 0,69 por hora, RTX 5090 de US$ 0,37 a 1,22, H100 de US$ 2 a 2,90 (faixas de Vast.ai e RunPod, outubro de 2026).
O ponto de virada cai muito quando o modelo aberto cabe em uma GPU — porque aí você não precisa de cluster, e modelos de 30 a 80 bilhões entregam o recorte que interessa a agentes de codificação.
Qual hardware você precisa para rodar local?
Na prática, a pergunta é quanta VRAM você tem. Um teste da Atomic Chat com nove modelos locais (julho de 2026) chegou a este mapa:
| VRAM | Melhor opção | Para quê |
|---|---|---|
| 8 GB | Falcon H1R 7B | Raciocínio e matemática — não é um agente |
| 12–16 GB | Gemma 4 12B | Tool calling nativo, autocomplete, tarefas curtas |
| 24 GB (RTX 3090/4090) | Qwen 3.6 27B / Qwen3-Coder 30B | O melhor que roda em uma GPU de consumidor; contexto até ~64K |
| 32 GB (RTX 5090) ou 32 GB Mac | Qwen 3.6 27B | Mesmo modelo, contexto até 262K |
| 48 GB (2× 3090) ou 64 GB Mac | Qwen3-Coder-Next 80B | Trabalho agêntico sério com contexto longo |
Três avisos que economizam frustração:
- Em trabalho agêntico de longa duração, a formatação de tool calls pode degradar quando o modelo é comprimido demais (quantização Q4, de 4 bits por peso) — considere a versão Q6 (6 bits).
- O KV cache cresce junto com o contexto: no Devstral Small 2, uma janela de 262K pede cerca de 40 GB só de cache.
- Um bom modelo de raciocínio não é automaticamente um bom agente: o Falcon H1R, por exemplo, não tem score de SWE-bench.
Ollama ou vLLM: qual usar?
Para começar, Ollama, LM Studio ou llama.cpp resolvem — instalação de minutos, perfeitos para um desenvolvedor testando sozinho. O teto aparece quando mais de um consumidor precisa do motor: em análises públicas de escalabilidade, o Ollama satura em torno de 22 requisições por segundo, independentemente da carga.
O passo seguinte é um engine de produção: vLLM ou SGLang, com continuous batching e cache de prefixo automáticos. Nos testes da Red Hat (2025) com o mesmo modelo e hardware, o vLLM entregou pico de 793 tokens por segundo contra 41 do Ollama — e latência P99 (o tempo máximo que 99% das requisições levam) de 80 ms contra 673 ms.
A regra prática fica assim: um agente e um desenvolvedor, Ollama basta. Vários agentes, vários usuários ou pipeline em produção, vLLM ou SGLang.
Quando vale a pena rodar agentes com modelos locais?
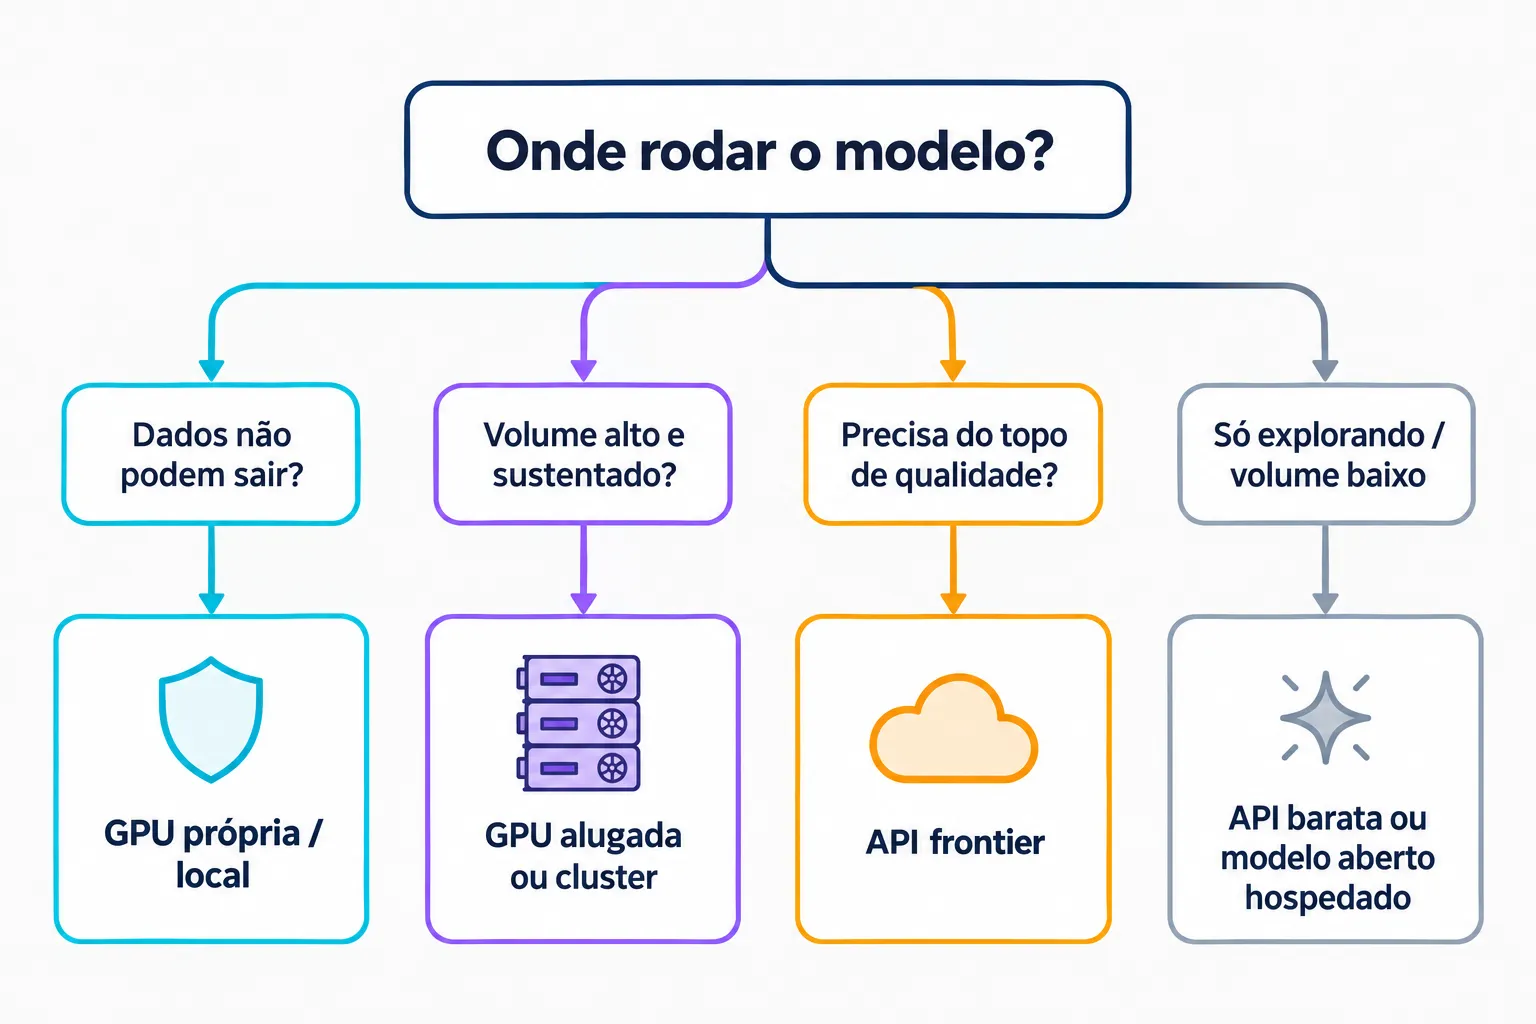
Recapitulando em forma de critério de bolso.
Vale a pena quando:
- Seus dados não podem sair — compliance, código sensível, dados de cliente.
- O volume é alto e sustentado — agentes rodando o dia inteiro aproximam você do ponto de virada.
- Latência local importa — ou você precisa funcionar offline.
- Você quer especializar — fine-tune numa tarefa estreita costuma bater o modelo genérico.
- Você quer independência — de rate limit, de reajuste de preço, de mudança silenciosa de modelo.
Não vale quando:
- Seu volume é baixo — GPU ociosa custa mais que a API mais barata.
- Você precisa do topo absoluto de qualidade — nos casos mais complexos, os fechados ainda lideram.
- Você não quer operar infra — GPU dá manutenção: driver, VRAM, atualização de serving.
Existe ainda um caminho do meio que vale conhecer: modelos abertos hospedados por terceiros, como Fireworks, Together e Groq. Você pula a operação e continua pagando por token — às vezes bem menos do que com GPU própria.
Próximos passos
Três movimentos, do mais barato ao mais sério:
Teste hoje com o que você tem. Instale o Ollama, baixe o Qwen 3.6 27B (se tiver 24 GB de VRAM) ou o Gemma 4 12B (12–16 GB) e aponte seu agente para
localhost:11434. O Cline conecta em Ollama e LM Studio sem configuração exótica.Meça antes de comprar. Compare seu consumo real (tokens/dia) com o ponto de virada da seção anterior. Sem números, “vale a pena” é palpite — e o post sobre por que agentes morrem no piloto mostra como custo por execução virou observabilidade obrigatória.
Suba para vLLM quando doer. Uma GPU só já se beneficia de continuous batching e cache de prefixo — e é o mesmo motor que as APIs comerciais usam por baixo do capô.
Se o aperto do momento é orçamento, existe um degrau antes de tudo isso: os melhores agentes gratuitos de 2026 resolvem muita coisa sem GPU e sem cartão.
O motor aberto deixou de ser brinquedo de entusiasta — com 30 a 80 bilhões de parâmetros, ele já roda o seu agente de verdade. A pergunta que sobrou não é mais “aberto ou fechado?”. É qual camada você quer operar — e essa resposta agora é sua.
Se a sua equipe está avaliando levar os agentes para modelos abertos — ou apenas reduzir a conta de tokens —, a ft.ia.br ajuda nessa avaliação.