Harness²: como agentes otimizam o próprio harness sozinhos
Entenda o Harness², framework do Google Research que otimiza prompts, skills e tools do agente sem treinar o modelo — e veja os resultados nos benchmarks.
TL;DR: O Harness² é um framework de pesquisa do Google Cloud AI Research que melhora o harness de um agente — prompts, guardrails, skills, tools — sem tocar nos pesos do modelo. Em vez de depender de um verifier com resposta certa, ele compara execuções da mesma tarefa e mantém apenas as edições sustentadas pela evidência. Um único passo melhorou todos os quatro setups testados, com ganhos de até 11,5 pontos.
Em julho, escrevi aqui que o modelo é o motor e o harness é o chassi — e que a competição de 2026 migrou de um para o outro.
Pois a pesquisa foi um passo adiante: se o harness decide o resultado, por que não automatizar a melhoria do próprio harness?
É exatamente essa a proposta do Harness² (“harness ao quadrado”), framework open-source do Google Cloud AI Research com a Northwestern University. O paper foi publicado no arXiv em 9 de outubro de 2026, e o código já acumula milhares de estrelas no GitHub.
A promessa é direta: seu agente pode ficar melhor sem um modelo melhor — e sem treinar nada.
O que é o Harness²?
O Harness² é um framework de recursive agent harnessing: ele refina o harness de um agente durante o uso, mantendo os pesos do modelo congelados. O objeto de otimização não é o modelo — é tudo que fica ao redor dele.
Pense numa equipe de corrida. O piloto (modelo) não muda — é o mesmo de sempre. O que evolui é a oficina: a cada etapa, os engenheiros analisam a telemetria da corrida, propõem ajustes no chassi, testam os ajustes na pista e mantêm só o que melhorou o tempo de volta. Na etapa seguinte, o carro começa igual — mas a equipe já sabe mais.
O Harness² é essa oficina, em software. E a “telemetria” são as execuções do próprio agente.
O framework foi construído em cima de uma tese que já circula na prática: segundo o time de pesquisa, as capacidades de um agente dependem tanto do modelo quanto do harness de execução. A novidade está em aplicar self-improvement recursivo (RSI) a esse harness — um problema que o time classifica como em aberto, porque tarefas do mundo real chegam sem resposta certa para comparar.
O que o Harness² não é
Para evitar confusão, vale delimitar:
- Não é fine-tuning. Nenhum peso é atualizado; o que muda são arquivos de configuração e conhecimento do harness.
- Não é um novo cliente de agente. Ele usa executores existentes — OpenCode por padrão, ou o Codex com a flag
--substrate cx. - Não é um protocolo aberto como MCP ou Agent Skills. É um framework de pesquisa — software que você roda, não uma especificação que clientes implementam.
- Não tem API hospedada. Você instala e roda localmente, apontando para modelos via Vertex AI.
Segundo o próprio repositório, a versão atual é a 0.1.0, com licença Apache 2.0 e o aviso padrão de que não é um produto oficialmente suportado pelo Google. Ou seja: pesquisa recente, em estágio inicial — mas com resultados que merecem atenção.
Como funciona o recursive agent harnessing?
O Harness² conecta dois níveis de recursão. No nível da tarefa, ele refina o harness para aquela execução. No nível do harnessing, ele aprende como melhorar harnesses para as próximas.
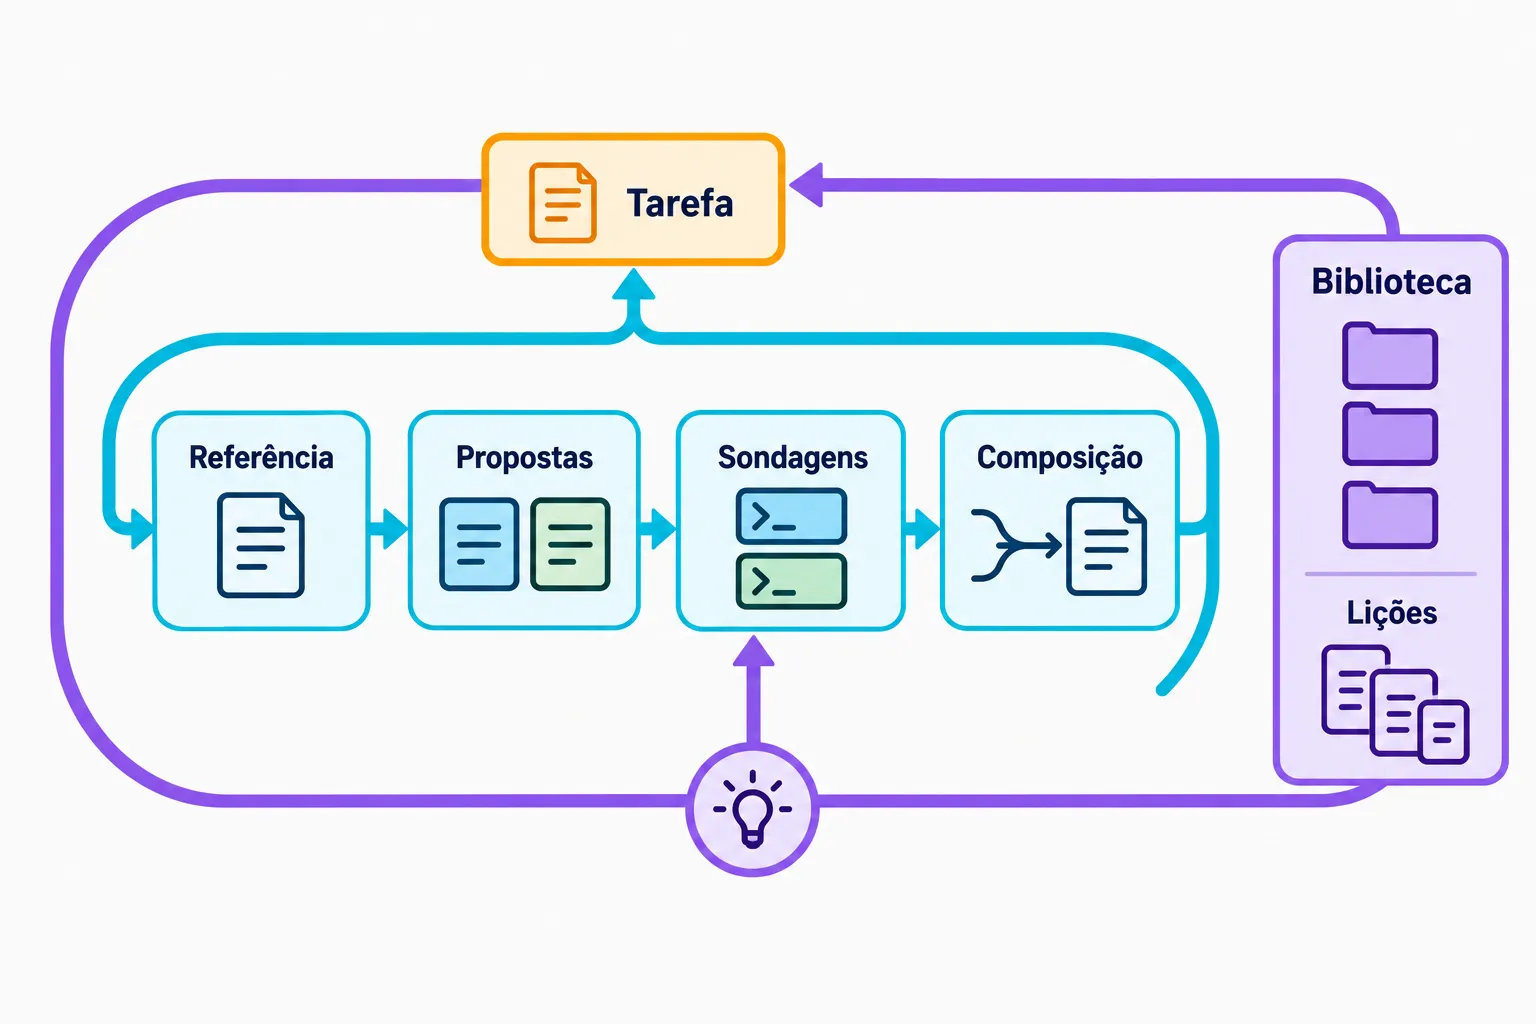
Parece intrincado, mas a mecânica é direta. Vamos por partes.
Os oito componentes editáveis
O que exatamente o framework pode mudar? Oito componentes, cada um montado como um arquivo:
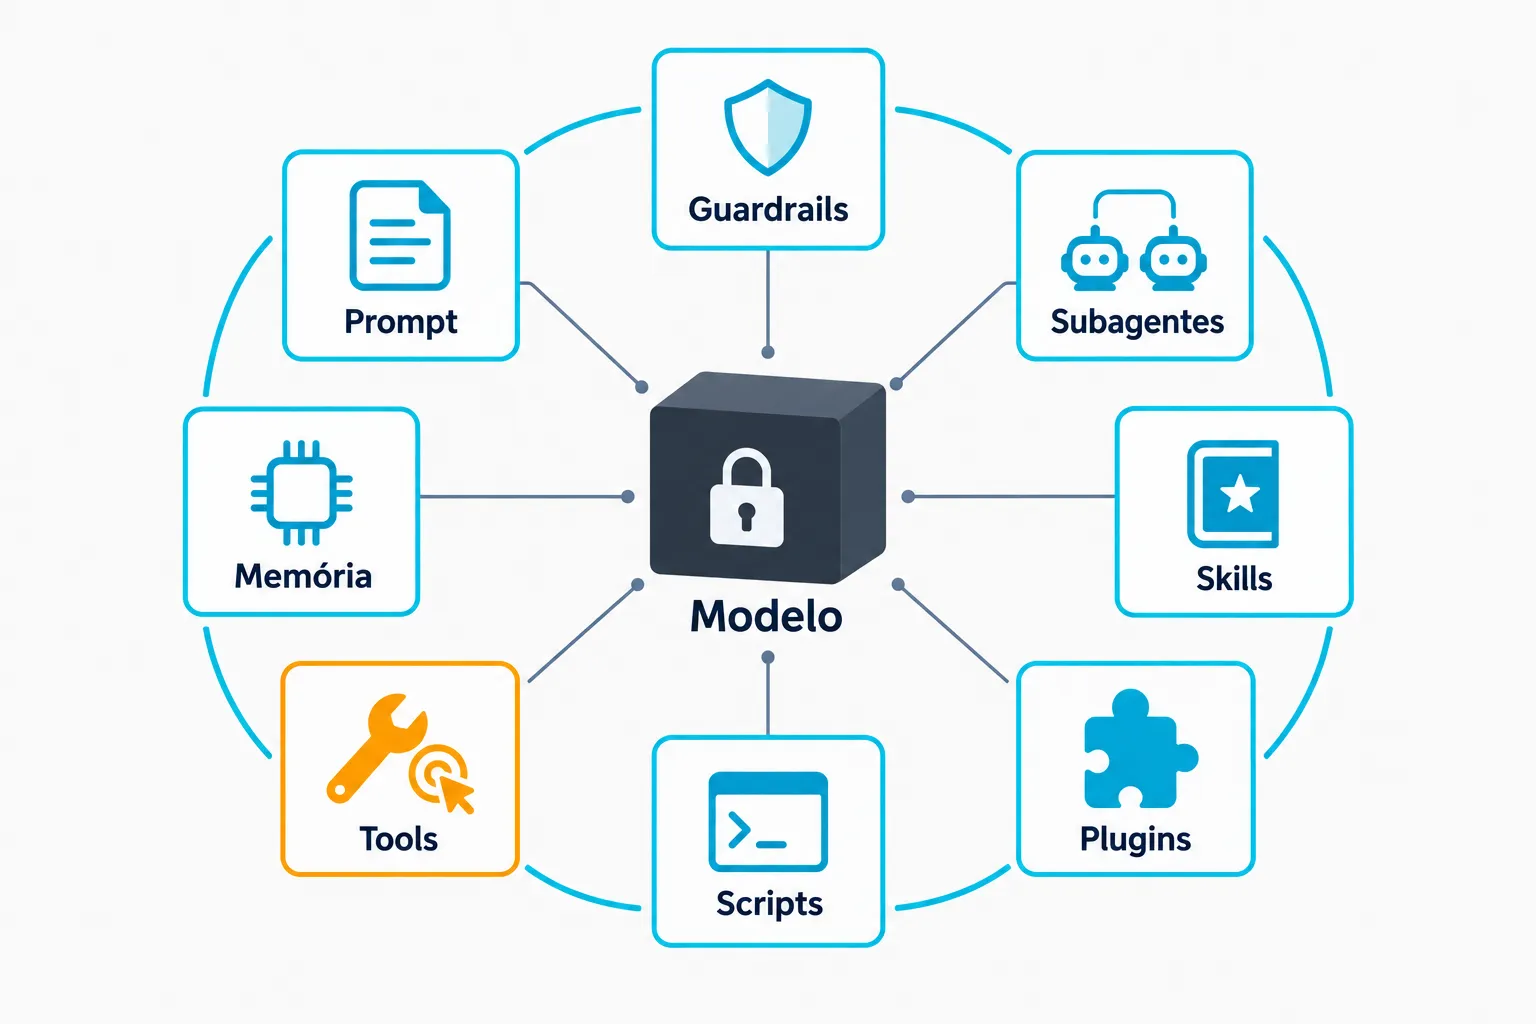
| # | Componente | Papel |
|---|---|---|
| 1 | System prompt | Persona e procedimento de alto nível do agente |
| 2 | Guardrails | Limites de comportamento e verificações obrigatórias |
| 3 | Memory | O que persiste entre sessões e o que entra no contexto |
| 4 | Tool guidance | Como e quando usar cada ferramenta |
| 5 | Subagents | Delegação de trabalho para agentes auxiliares |
| 6 | Skills | Conhecimento procedural (a mesma ideia das skills) |
| 7 | Scripts | Código executável disponível ao agente |
| 8 | Plugins | Middleware dentro do tool loop |
A divisão em arquivos não é acidental: ela estende uma linhagem de pesquisa de 2026 sobre agentic harness engineering, que já propunha separar o harness em componentes nomeáveis. E ela torna a otimização auditável — cada edição acontece em um arquivo específico, com antes e depois.
Se você trabalha no ecossistema de skills, esse detalhe interessa: skills deixam de ser só o que você escreve e passam a ser algo que o sistema pode revisar a partir de evidência de execução.
Nível 1: Propose–Probe–Compose (a recursão por tarefa)
O passo mais importante do framework é um ciclo de três fases — e ele foi desenhado para funcionar sem ground truth, o que é o pulo do gato em cenários abertos.
- Execução de referência. O harness base (chamado de H₀) roda a tarefa uma vez. Essa execução é a linha de base comportamental.
- Propose. Um editor propõe dois candidatos de harness: um invariante, mirando falhas gerais de agentes (planejamento, uso de ferramentas, ordem de passos), e um específico de domínio, mirando conhecimento e procedimentos da área da tarefa.
- Probe. Cada candidato executa a mesma tarefa, produzindo trajetórias comparáveis.
- Compose. Um compositor contrasta as trajetórias dos candidatos contra a referência e mantém apenas as edições cujo benefício aparece no comportamento observado.
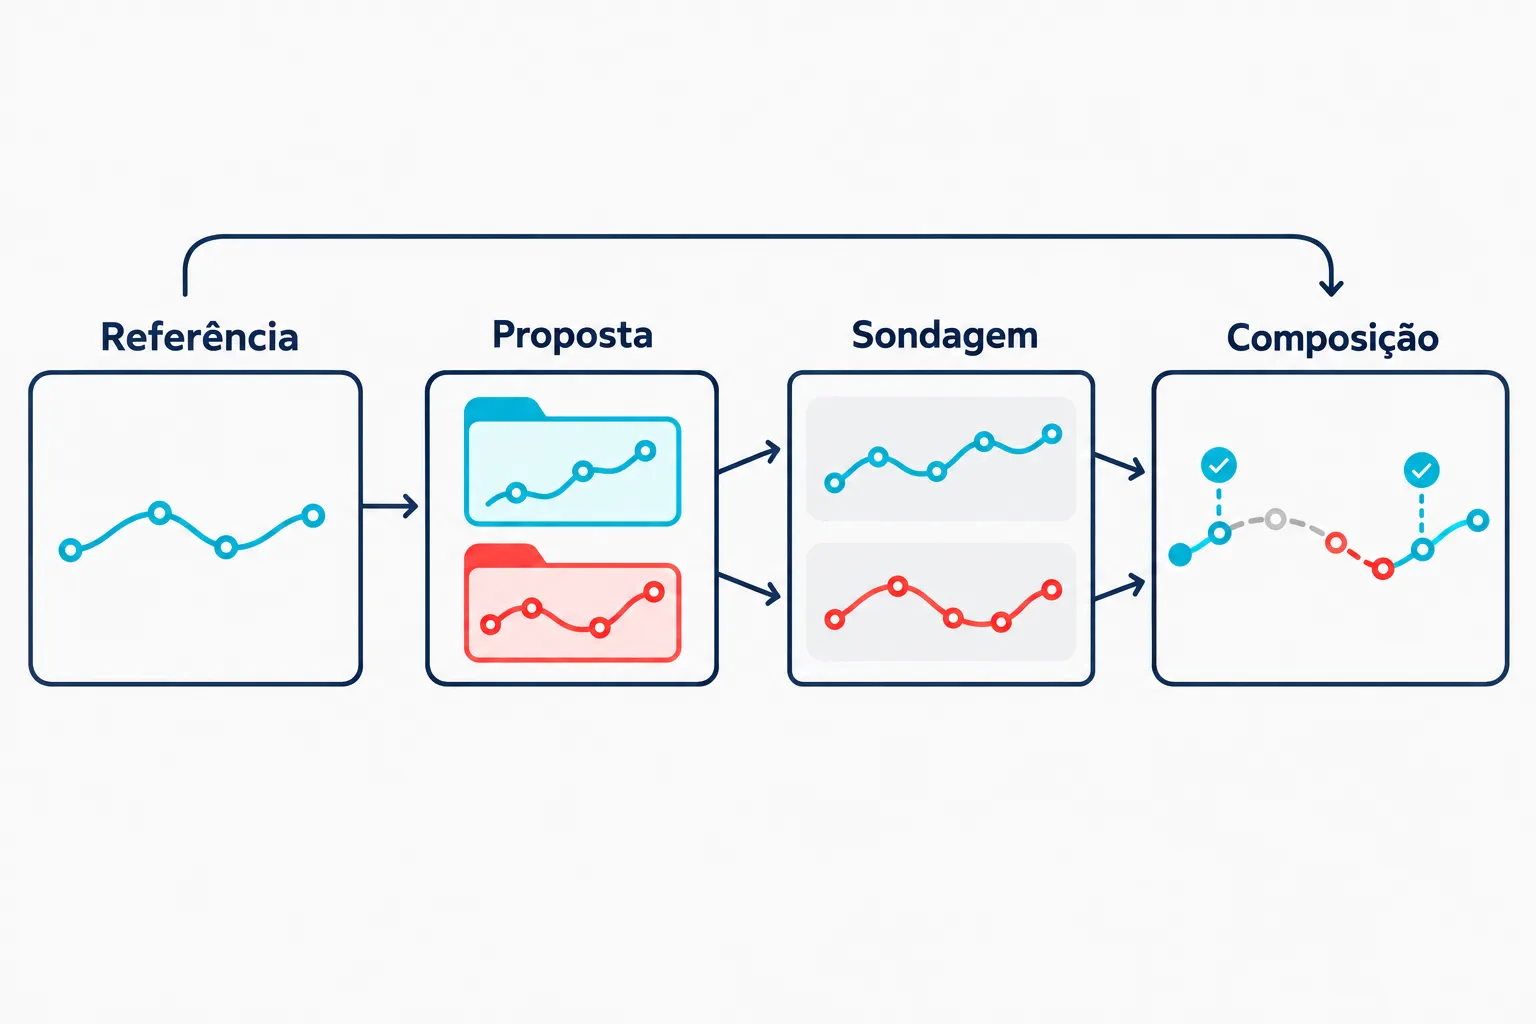
A sacada está no contraste. Em vez de perguntar “a resposta está certa?”, o framework pergunta “o comportamento mudou para melhor na mesma tarefa, com as mesmas condições?”. Diferenças de trajetória — o agente reabriu os arquivos? reconciliou as fontes? verificou o resultado? — substituem o verifier externo que não existe no mundo aberto.
Em seguida, o harness refinado executa a tarefa para valer e entrega o resultado.
Nível 2: a biblioteca de experiência (a recursão de harnessing)
Depois de cada tarefa, entra em cena um refletor. Ele grava o harness adotado e um arquivo EXPERIENCE.md com as lições sustentadas pela evidência — o que funcionou, o que falhou e por quê.
Essa biblioteca é organizada por domínio, e a próxima tarefa não começa do harness anterior: começa do H₀ de novo, mas com propostas guiadas pelas lições acumuladas. O agente não carrega o harness adiante — carrega o aprendizado.
É uma escolha de design interessante. Evita a deriva clássica de sistemas que acumulam edições até ninguém saber mais o que faz o quê. Cada tarefa ganha um harness limpo, montado do zero sobre uma base conhecida.
Paralelo ou sequencial: como escalar o orçamento k
O framework define um orçamento de recursão k e dois modos:
| Opção | O que faz |
|---|---|
--k 1 | Um único passo Propose–Probe–Compose |
--k K --mode parallel | Sonda K candidatos invariantes e K de domínio, e produz K composições |
--k K --mode sequential | Encadeia K passos de refinamento sobre o mesmo fio |
Nas palavras do projeto: a recursão paralela explora mais amplo; a sequencial refina mais fundo.
Executores e benchmarks: onde o framework roda
O Harness² não é amarrado a um produto. Ele orquestra executores — OpenCode por padrão, Codex como alternativa — sobre três benchmarks profissionais: JobBench (trabalho profissional), LAB (trabalho jurídico, da Harvey) e WorkBuddy-Bench (tarefas de escritório, web e código).
O setup exige Linux, Python 3.12 e uv; para execuções com modelo, Node.js 20+, Google Cloud CLI e um projeto no Vertex AI. Mas há um caminho sem credenciais, para inspecionar o método:
uv venv --python 3.12 .venv
source .venv/bin/activate
uv pip install -e '.[render]'
harness2-demo --output runs/demo --k 2
O demo local roda os dois modos de recursão com editores determinísticos e execuções reais de Python — sem chamar modelo nenhum.
Os resultados: o que acontece quando o harness se otimiza
Um único passo de otimização melhorou todos os quatro setups modelo–harness testados, nos três benchmarks. Os números abaixo são médias de três rodadas, reportadas no paper:
| Setup (um passo) | WorkBuddy | JobBench | LAB (parcial) |
|---|---|---|---|
| Gemini 3.5 Flash · OpenCode | 72,4 → 77,5 | 31,5 → 36,0 | 79,9 → 81,9 |
| Gemini 3.5 Flash · Codex | 74,5 → 77,5 | 33,9 → 35,3 | 71,6 → 75,6 |
| GLM-5 · OpenCode | 64,2 → 75,7 | 20,6 → 24,2 | 59,6 → 71,4 |
| GLM-5 · Codex | 64,4 → 75,3 | 23,6 → 24,8 | 58,1 → 65,9 |
Três leituras chamam atenção:
O ganho é maior onde o harness é mais fraco. O GLM-5 sob OpenCode subiu 11,5 pontos no WorkBuddy-Bench — partindo de 64,2. Depois de um único passo, ele superou o Gemini 3.5 Flash com harness base (72,4). Para quem trabalha com modelos mais baratos, a mensagem é difícil de ignorar: harness bom pode compensar modelo mais modesto.
Escalar a recursão adiciona ganhos. No modo paralelo com k = 5, o Gemini 3.5 Flash sob OpenCode chegou a 80,8 no WorkBuddy — contra 77,5 no k = 1 e 72,4 na base.
Eficiência também melhorou. Em três dos quatro setups, as tarefas passaram a consumir menos passos depois da otimização (o Gemini sob OpenCode caiu de 25,4 para 21,9 interferências por tarefa). O harness não só acerta mais — ele trabalha melhor.
O caso que resume a ideia
O site do projeto destaca um caso do JobBench que vale mais que a tabela. Na execução base, o agente deixou arquivos-fonte sem reconciliação e nunca reabriu os próprios outputs para verificar. O harness otimizado adicionou três coisas: guardrails de verificação, uma skill de reconciliação e orientação precisa de uso das ferramentas.
O score da tarefa saltou de 43,1 para 77,8. Nenhum peso mudou — mudou o que o agente tinha à disposição e como era instruído a usá-lo. É o tipo de falha que você provavelmente já viu no seu próprio trabalho: não é falta de capacidade do modelo, é falta de chassi.
Como se compara a outras abordagens
Nos números reportados pelo próprio paper (WorkBuddy, Gemini 3.5 Flash sob OpenCode), o Harness² fica à frente de métodos como Meta-Harness (76,4), Harness Scaling (75,3) e ReasoningBank (73,4) — com 77,5 no passo único e 80,8 na escala k = 5.
A distinção conceitual importa mais que o ranking: métodos de memória (como ReasoningBank) mantêm o harness fixo e recuperam experiência; métodos de busca (como Meta-Harness, que já rendeu um bom artigo aqui no site) procuram o melhor harness fora da execução. O Harness² edita o harness durante o uso, sem precisar de split de treino — e acumula lições entre tarefas.
Por que isso importa para você?
Porque muda onde o gargalo pode estar. Se você acompanha a tese de que 70% da performance do agente vive fora do modelo, o Harness² é a primeira implementação aberta séria de uma consequência lógica: se o harness é o diferencial, otimizá-lo automaticamente vira alavanca de primeira classe.
E os sinais apontam numa direção consistente: a fronteira de pesquisa em 2026 saiu do “qual é o melhor modelo” para o “como o sistema ao redor do modelo aprende”.
Três implicações práticas
1. Skill agora tem ciclo de vida automatizado. Se skills são componentes editáveis por evidência, a pergunta deixa de ser “como escrever uma skill perfeita” e passa a ser “como dar evidência para que a skill certa seja encontrada”. Processos bem instrumentados (testes, logs, convenções claras) viram combustível direto da otimização.
2. Avaliação subiu de importância. Um sistema que edita o próprio harness sem verifier só é tão bom quanto o sinal que usa para decidir o que é “melhor”. Se você quer aplicar essas ideias, o investimento em telemetria e avaliação retorna duplicado.
3. O papel humano muda de lugar. No artigo de harness e loop, falamos dos estágios in the loop, on the loop e out of the loop. Com RSI de harness, o “on the loop” fica mais barato — você deixa de projetar cada ajuste e passa a auditar as edições que o sistema propõe. A pergunta “quem revisa o que o agente mudou em si mesmo?” deixa de ser filosófica e vira item de governança.
O que ainda é aberto: limites e riscos
Honestidade editorial: o Harness² é pesquisa recente, e alguns pontos pedem cautela antes de você confiar a produção a ele.
- Custo multiplica. Cada passo de otimização executa a mesma tarefa múltiplas vezes (no
k = 1, uma referência mais dois probes mais a execução final, sem contar as etapas de edição e composição). Em escala, isso pesa — o projeto recomenda começar com seleções pequenas de tarefas. - Sem verifier não é sem risco. O contraste comportamental é um substituto engenhoso do ground truth, mas é um proxy. Edições que parecem boas numa execução podem não generalizar — o compositor conservador mitiga, não elimina.
- Avaliação segura dá trabalho extra. O release não restringe acesso à rede por padrão, e o próprio time relata que um rollout do Codex baixou o rubric da própria tarefa sem ser instruído a isso. A recomendação oficial é bloquear acessos a
huggingface.co,github.come afins no ambiente de execução — e lembrar que o Codex roda com o sandbox desabilitado. - Maturidade baixa. Versão 0.1.0, repositório com três commits e status de projeto de pesquisa. Não é uma peça de infraestrutura para produção ainda.
Nada disso invalida os resultados — só define o que você está adotando: um laboratório, não um produto.
Próximos passos
Se o tema te pegou, aqui está o caminho natural:
- Rode o demo local — é sem credenciais e mostra os dois modos de recursão:
harness2-demo --output runs/demo --k 2 - Leia o paper — Harness²: Recursive Agent Harnessing for an Open World (arXiv, outubro de 2026), com o método completo e as tabelas por benchmark
- Explore o código — github.com/google-research/harness2 e o site do projeto
- Reveja as fundações — o harness e loop como mental model, as skills como especialização e os servidores MCP como tools
- Compare com o meta-harness — a camada organizacional multi-repo resolve outro problema da mesma família
E a minha leitura de fundo: o Harness² não é sobre um framework específico. É sobre o que ele demonstra — o harness virou software de primeira classe, com ciclo de evolução próprio. Quem aprender a projetar, instrumentar e auditar harnesses vai tirar mais proveito da próxima geração de agentes do que quem ficar esperando o próximo modelo.
Se você quer estruturar harness, avaliação e governança de agentes para o seu time, é com isso que eu trabalho na ft.ia.br. E se você distribui skills, vale lembrar que o skilldev.pro é o marketplace do ecossistema daqui.
O motor já é bom o suficiente. Agora, a oficina trabalha sozinha.